งานเยอะ ข้อมูลกระจัดกระจาย หัวหน้าตามงานทุกวัน แล้วสุดท้ายเอาทุกอย่างโยนให้ AI — เรากำลังแก้ปัญหา หรือแค่ย้ายความยุ่งไปอีกที่?
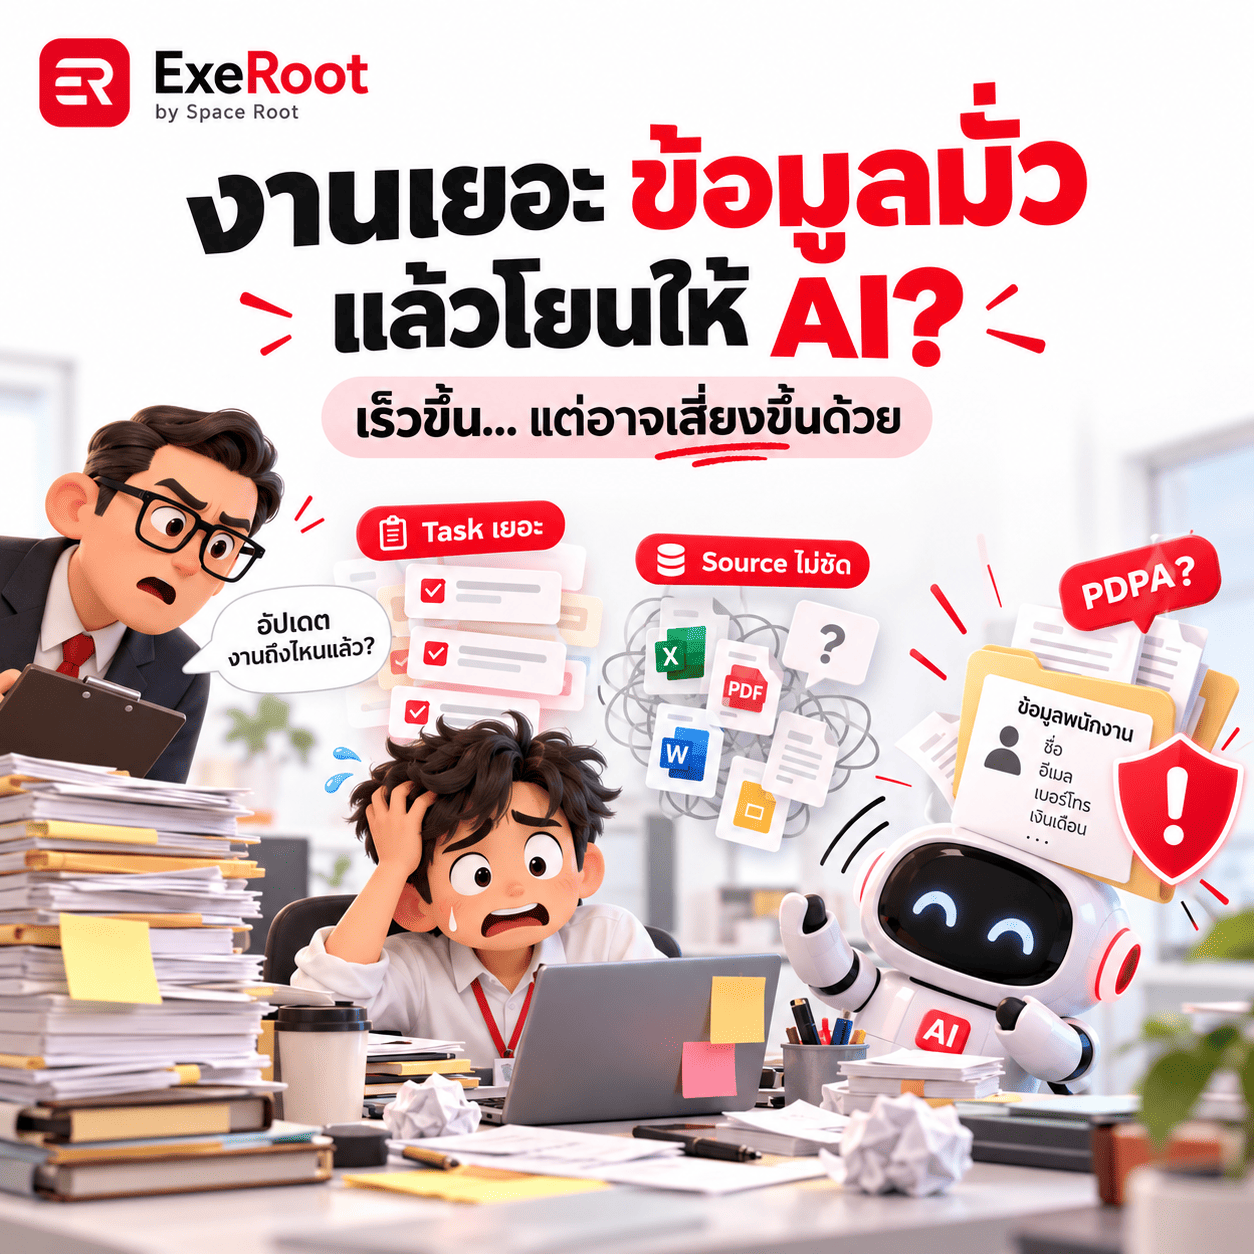
ช่วงหลังผมเห็นภาพหนึ่งเกิดขึ้นในหลายองค์กรมากขึ้นเรื่อย ๆ พนักงานมี Task เต็มหน้าจอ หัวหน้าตามงานผ่าน Line อีกทีมส่งข้อมูลมาทาง Email บางเรื่องอยู่ใน Excel บางเรื่องอยู่ใน Google Drive บางเรื่องอยู่ในแชต และบางเรื่องทุกคนจำได้ว่ามีคนเคยส่งมา แต่ไม่มีใครตอบได้แล้วว่าไฟล์ล่าสุดอยู่ที่ไหน พอถึงเวลาประชุม สิ่งที่ควรเป็นคำถามเชิงบริหารอย่าง “เราควรตัดสินใจอย่างไรต่อ?” กลับถูกแทนที่ด้วยคำถามพื้นฐานว่า ตัวเลขนี้มาจากไหน Version ล่าสุดหรือยัง ใครเป็นเจ้าของเรื่องนี้ ทำไมเมื่อวานเป็นอีกตัวเลขหนึ่ง และสรุปแล้วงานนี้จะเสร็จเมื่อไร เมื่อความยุ่งสะสมมากขึ้น คำตอบใหม่ที่หลายองค์กรหันไปหาอย่างรวดเร็วคือ “เอาให้ AI ช่วยสรุปสิ” ฟังดูสมเหตุสมผลมาก เพราะถ้ามีไฟล์เยอะก็โยนเข้า AI ถ้ามี Meeting ยาวก็ให้ AI สรุป ถ้ามีข้อมูลลูกค้าเยอะก็ให้ AI วิเคราะห์ ถ้า Excel อ่านไม่ไหวก็ Upload ทั้งไฟล์เข้าไป งานที่เคยใช้เวลาหลายชั่วโมงอาจเหลือเพียงไม่กี่นาที และในหลายกรณี AI ก็ช่วยลดภาระงานได้จริง แต่ผมคิดว่าตรงนี้มีคำถามสำคัญที่องค์กรควรกลับมาคิดให้ลึกกว่าเดิมว่า ถ้าข้อมูลต้นทางยังไม่ชัด งานยังไม่มีระบบ Priority ยังไม่ชัด และไม่มีใครรู้ด้วยซ้ำว่าข้อมูลชุดไหนควรถูกส่งไปที่ใด การเพิ่ม AI เข้าไปจะทำให้องค์กรตัดสินใจดีขึ้นจริง หรือเพียงทำให้ “ความยุ่งแบบเดิม” ถูกประมวลผลได้เร็วขึ้นเท่านั้น ที่สำคัญกว่านั้น ในระหว่างที่ทุกคนรีบใช้ AI เพื่อจัดการกับข้อมูลจำนวนมหาศาล เราอาจสร้างความเสี่ยงใหม่ขึ้นมาโดยไม่ตั้งใจ เพราะไม่ใช่ทุกข้อมูลที่ควรถูกส่งเข้า AI และไม่ใช่ทุก AI Tool ที่ควรได้รับข้อมูลจริงของบริษัทโดยอัตโนมัติ
ปัญหาที่แท้จริงอาจไม่ใช่งานเยอะ แต่คือไม่มีใครรู้ว่าอะไรสำคัญจริง
เวลาพนักงานบอกว่างานเยอะ เรามักตีความทันทีว่าเป็นปัญหา Capacity หรือ Headcount แต่ในหลายองค์กร สิ่งที่หนักกว่า “จำนวนงาน” คือความไม่ชัดเจนของ Priority พนักงานอาจมี Task 20 เรื่องอยู่ตรงหน้า แต่ไม่รู้ว่า 3 เรื่องไหนมีผลกับลูกค้า รายได้ หรือ Strategy มากที่สุด ขณะที่หัวหน้าก็มองเห็นงานเต็มไปหมด แต่ไม่มีภาพเดียวกันว่าเรื่องไหนกำลังเสี่ยง เรื่องไหนรอได้ และเรื่องไหนถ้าช้าไปหนึ่งสัปดาห์จะกระทบ Business จริง เมื่อ Priority ไม่ชัด วิธีบริหารจึงค่อย ๆ กลายเป็น “ตามทุกเรื่อง” หัวหน้าต้องถามว่างาน A ถึงไหน งาน B เสร็จหรือยัง ใครรับผิดชอบงาน C ลูกค้ารายนี้ตอบหรือยัง พนักงานจึงใช้เวลาส่วนหนึ่งทำงานจริง และอีกส่วนหนึ่งใช้ตอบว่าตัวเองกำลังทำอะไรอยู่ นี่คือสิ่งที่เรียกว่า Coordination Cost เวลาจำนวนมากไม่ได้ถูกใช้ในการสร้าง Output แต่ถูกใช้เพื่อทำให้ทุกคนรู้ว่าใครกำลังทำอะไรอยู่ และยิ่งองค์กรโตขึ้น Cost ตรงนี้ยิ่งโตตาม เพราะจำนวน Task, Dependency และคนที่ต้องประสานงานเพิ่มเร็วกว่าความสามารถของมนุษย์ที่จะจำทุกอย่างไว้ในหัว ตรงนี้ทำให้ผมคิดว่า Manager ที่ “ตามงานเก่ง” ไม่ได้แปลว่าองค์กรมีระบบบริหารที่ดีเสมอไป ถ้าวันหนึ่ง Manager คนนั้นลาพักร้อนแล้วทีมเริ่มไม่รู้ว่าอะไรต้องทำต่อ อาจแปลว่าองค์กรไม่ได้มี Management System แต่มี Manager คนหนึ่งที่ทำหน้าที่เป็นระบบด้วยตัวเอง ตอนที่คนเก่งยังอยู่ ทุกอย่างดูเหมือนเดินได้ เพราะเขาจำได้ว่าใครทำอะไร รู้ว่าต้องตามใคร และรู้ว่าเรื่องไหนกำลังจะหลุด แต่ความรู้ทั้งหมดนั้นอยู่ในหัวคนไม่กี่คน เมื่อคนเหล่านั้นไม่อยู่ ระบบก็หยุดทำงานทันที ระบบบริหารที่ดีจึงไม่ควรออกแบบมาเพื่อทำให้หัวหน้าตามงานได้เร็วขึ้นอย่างเดียว แต่ควรลดความจำเป็นของการ “ต้องตาม” ลงตั้งแต่แรก เพื่อให้ Manager เอาเวลาไปใช้กับการปลด Bottleneck การตัดสินใจ การ Coaching การจัด Priority และการแก้ปัญหาที่ทีมแก้เองไม่ได้ มากกว่าจะทำหน้าที่เป็น Human Notification System ตลอดทั้งวัน
ข้อมูลเยอะไม่ได้แปลว่าเรามีข้อมูลที่พร้อมใช้ตัดสินใจ
อีกปัญหาที่เกิดขึ้นพร้อมกันคือ ทุกคนมีตัวเลข แต่ไม่มีใครตอบได้อย่างมั่นใจว่าตัวเลขเหล่านั้นมาจากไหน Sales มีตัวเลขชุดหนึ่ง Finance มีอีกชุด Dashboard แสดงอีกชุดหนึ่ง พอผู้บริหารถามว่า “แล้วตัวไหนถูก?” ห้องประชุมกลับเงียบลงก่อนจะมีคนบอกว่า “ขอกลับไปเช็กก่อนครับ” นี่ไม่ใช่เพียงปัญหาเรื่องไฟล์เยอะ แต่เป็นเรื่องของ Data Provenance หรือความสามารถในการตอบว่าข้อมูลนี้มาจาก Source ไหน ผ่านการแก้ไขอะไรมาบ้าง ใช้ Definition แบบไหน และใครเป็นคนรับผิดชอบ ต่อให้มี AI เก่งมากเพียงใด ถ้าต้นทางไม่ชัด ปัญหานี้ก็ไม่ได้หายไป เพราะ AI ไม่สามารถทำให้ข้อมูลผิดกลายเป็นข้อมูลถูกเพียงเพราะมันสามารถสรุปออกมาได้ดี หลัก Garbage In, Garbage Out จึงยังไม่หายไปในยุค Generative AI เพียงแต่ความเสี่ยงเปลี่ยนรูปไปเล็กน้อย เมื่อก่อนข้อมูลผิดอาจทำให้เราเห็น Error หรือเห็นตัวเลขเพี้ยนชัด ๆ แต่วันนี้ AI สามารถรับข้อมูลที่ไม่ครบ แล้วเขียนคำอธิบายออกมาได้อย่างลื่นไหล มีโครงสร้าง และดูน่าเชื่อถือมาก สมมติเราถาม AI ว่า “ทำไมยอดขายลด?” แล้วส่งให้เพียงข้อมูลยอดขายกับจำนวน Sales โดยไม่มีข้อมูลราคา Marketing Spend, Pipeline, คู่แข่ง หรือ Capacity ของทีม AI ยังสามารถสร้างคำอธิบายที่ฟังดูดีได้ แต่สิ่งที่เราได้อาจเป็นเพียง Plausible Explanation ไม่ใช่ Correct Explanation นี่เป็นเหตุผลว่าทำไม Data Literacy จะยิ่งสำคัญขึ้นในยุค AI เพราะต้นทุนในการสร้างคำตอบลดลงมาก แต่ต้นทุนในการแยก “คำตอบที่ถูก” ออกจาก “คำตอบที่ฟังดูดี” อาจกลับสูงขึ้นแทน Manager ในอนาคตจึงอาจต้องรู้เรื่องข้อมูลมากขึ้น ไม่ใช่เพื่อไปทำงานแทน Data Analyst แต่เพื่อให้สามารถถามได้ว่า ข้อมูลชุดนี้ครอบคลุมคำถามหรือยัง Definition เหมือนกันหรือไม่ มี Missing Data ตรงไหน มี Bias หรือไม่ และสิ่งที่เห็นเป็นเพียง Correlation หรือมีหลักฐานพอจะพูดถึง Causation ได้จริง AI ทำให้ Analysis ง่ายขึ้นก็จริง แต่ความง่ายของ Analysis ไม่ได้หมายความว่าคุณภาพของการตัดสินใจจะดีขึ้นโดยอัตโนมัติ
เมื่อข้อมูลยุ่ง AI มักถูกใช้เป็น “ทางลัด” แล้ว Shadow AI ก็เริ่มเกิด
ลองนึกถึงสถานการณ์จริง พนักงานต้องทำ Report ด่วน บริษัทไม่มี AI Tool กลางที่ตอบโจทย์ หัวหน้าบอกว่า “ใช้ AI ช่วยก็ได้ จะได้เร็ว” พนักงานจึงเปิด Account ส่วนตัวแล้ว Upload Excel ของลูกค้าเข้าไป อีกคนเอา Meeting Transcript เข้า AI เพื่อสรุป อีกคนส่งรายชื่อพนักงานและ Performance Rating ไปให้ช่วยวิเคราะห์ ทุกคนมีเจตนาดี เพราะต้องการให้งานเสร็จเร็วขึ้น แต่ปัญหาคือองค์กรอาจไม่รู้เลยว่าข้อมูลของบริษัทกำลังเดินทางไปอยู่ที่ไหนบ้าง นี่คือสิ่งที่เรียกว่า Shadow AI ซึ่งมีลักษณะคล้าย Shadow IT ในอดีต กล่าวคือ Technology ถูกนำมาใช้ก่อนที่ Governance ขององค์กรจะตามทัน และมีความเข้าใจผิดอย่างหนึ่งที่ผมคิดว่าต้องระวังมาก คือ “พนักงานเปิดข้อมูลชุดนี้ได้อยู่แล้ว ก็เอาเข้า AI ได้สิ” ความจริงไม่จำเป็นต้องเป็นแบบนั้น เพราะสิทธิ์ในการเข้าถึงข้อมูลเพื่อทำงาน กับสิทธิ์ในการส่งข้อมูลไปให้ผู้ให้บริการภายนอกประมวลผล เป็นคนละเรื่องกัน พนักงานอาจมีสิทธิ์ดู Customer List เพราะต้องใช้เพื่อขาย แต่ไม่ได้หมายความว่าสามารถ Upload Customer List ทั้งชุดเข้า AI ภายนอกได้โดยอัตโนมัติ เช่นเดียวกับข้อมูลพนักงาน Resume, Performance Rating, Compensation, Complaint หรือบทสนทนากับลูกค้า ซึ่งอาจมีทั้งข้อมูลส่วนบุคคลและข้อมูลธุรกิจที่มีความอ่อนไหวอยู่ภายใน คำถามจึงไม่ใช่เพียงว่า “AI ตัวนี้ปลอดภัยไหม” แต่ต้องถามว่า เรามีเหตุผล ความจำเป็น และสิทธิ์เพียงพอหรือไม่ที่จะส่งข้อมูลชุดนี้ไปให้ระบบนั้นประมวลผล
Privacy ไม่ควรถูกถามหลังจาก Workflow ใช้งานไปแล้ว
อีก Pattern หนึ่งที่เห็นบ่อยคือ ทีมเริ่มทดลอง AI ก่อน พอเห็นว่าเวิร์กก็เริ่มเอาข้อมูลจริงเข้า จากนั้นขยายไปอีกหลายทีม แล้วค่อยถาม Legal ทีหลังว่า “แบบนี้ทำได้ไหม” ผมคิดว่าลำดับแบบนี้ควรถูกกลับด้าน โดยเฉพาะ Workflow ที่เกี่ยวข้องกับข้อมูลส่วนบุคคล Privacy ควรถูกคิดตั้งแต่ตอนออกแบบ Process ซึ่งก็คือแนวคิดของ Privacy by Design ไม่ได้หมายความว่าทุก Use Case ต้องหยุดรอเอกสารเป็นเดือน แต่หมายความว่าเราควรถามตั้งแต่ต้นว่า จำเป็นต้องใช้ข้อมูลทั้งหมดหรือไม่ สามารถตัดชื่อออกได้ไหม ใช้ Aggregate Data ได้หรือเปล่า Mask ข้อมูลก่อนส่งได้หรือไม่ ต้องส่งทั้งไฟล์หรือเฉพาะ Field ที่จำเป็น Output จะเก็บไว้นานแค่ไหน ใครเปิดดูได้ และ AI Provider ใช้ข้อมูลตามเงื่อนไขแบบใด เพียงแค่ถามคำถามเหล่านี้ก่อนเริ่ม ความเสี่ยงหลายอย่างก็ลดลงได้โดยไม่จำเป็นต้องทำให้ Innovation หยุดชะงัก
“โยนทั้ง Folder ให้ AI หาเอง” สะดวก แต่ไม่ใช่แนวทางที่ดีเสมอไป
Generative AI ทำให้เรามีนิสัยใหม่คือ ถ้าไม่รู้ว่าอะไรสำคัญ ก็ Upload ทั้งหมดเข้าไปก่อนแล้วให้ AI หาเอง ฟังดูง่ายมาก แต่ในมุม Governance ไม่ใช่แนวคิดที่ดีเสมอไป หลักที่เหมาะกว่าคือ Data Minimization หรือใช้ข้อมูลเท่าที่จำเป็นต่อวัตถุประสงค์นั้นจริง ๆ ถ้าต้องการดู Trend ของ Complaint อาจไม่จำเป็นต้องส่งชื่อหรือเบอร์โทรของลูกค้า ถ้าต้องการวิเคราะห์ Skill Gap อาจไม่ต้องส่งวันเกิดหรือที่อยู่ของพนักงาน และถ้าต้องการสรุป Meeting บางส่วนที่เป็นเรื่องส่วนบุคคลอาจไม่จำเป็นต้องเข้า AI เลย Data Minimization ไม่ได้มีประโยชน์แค่เรื่อง Compliance แต่เป็นหลัก Engineering ที่ดีด้วย เพราะข้อมูลที่น้อยลงหมายถึง Attack Surface ที่น้อยลง ความเสี่ยงลดลง และบางครั้งคุณภาพของ Output ก็ดีขึ้นเพราะ Noise ลดลงด้วย
สิ่งที่ต้องระวังคือการเอา AI ไปวางทับ “Operational Mess”
ผมคิดว่านี่เป็นแก่นสำคัญที่สุดของบทความนี้ เวลาข้อมูลในองค์กรเริ่มยุ่ง เรามักมีแรงดึงดูดให้ใช้ AI เป็นทางลัด หาไฟล์ไม่เจอก็ถาม AI ไม่รู้ไฟล์ไหนล่าสุดก็โยนหลายไฟล์ให้ AI สรุป Meeting เยอะก็ให้ AI จำทั้งหมด Task เยอะก็ให้ AI Prioritize ซึ่งทั้งหมดนี้มีประโยชน์ถ้า Process ต้นทางดีอยู่แล้ว แต่ถ้าด้านล่างยังไม่มี Owner ไม่มี Priority ไม่มี Source of Truth และไม่มี Definition ที่ตรงกัน สิ่งที่เรากำลังสร้างอาจเป็นเพียง AI Layer บน Operational Mess ด้านล่างยังยุ่งเหมือนเดิม เพียงแต่ AI ช่วยปิดบังความยุ่งนั้นอยู่ด้านบน วันไหน AI ตอบผิด ข้อมูลเปลี่ยน หรือ Context หาย ปัญหาข้างล่างก็ยังอยู่เหมือนเดิม เพราะเราไม่เคยแก้โครงสร้างต้นเหตุเลย ดังนั้นก่อนเอา AI เข้า Process ผมคิดว่าองค์กรควรตอบให้ได้อย่างน้อยสี่เรื่อง ได้แก่ งานนี้มี Owner และ Priority ชัดหรือยัง ข้อมูลมาจาก Source ไหนและเชื่อถือได้เพียงใด Output จะถูกนำไปใช้ตัดสินใจเรื่องอะไร และข้อมูลชุดนี้สามารถถูกส่งเข้า AI ได้หรือไม่พร้อมกับมีคนรับผิดชอบชัดเจน ถ้ายังตอบไม่ได้ AI อาจทำให้ Process เร็วขึ้น แต่ไม่ได้หมายความว่าจะทำให้ Process ดีขึ้น
Manager ในยุค AI ต้องเปลี่ยนจาก “คนตามงาน” เป็น “คนออกแบบระบบงาน”
ผมคิดว่า Manager ที่เก่งในอนาคตอาจไม่ใช่คนที่จำ Task ของลูกทีมได้ครบที่สุด แต่เป็นคนที่ทำให้ทีมสามารถมองเห็นได้เองว่า อะไรสำคัญ ใครเป็น Owner Deadline คือเมื่อไร Blocker อยู่ตรงไหน ข้อมูลอยู่ที่ไหน และเรื่องไหนต้อง Escalate เมื่อระบบพื้นฐานเหล่านี้ชัด AI จะเข้ามาช่วยได้ดีมาก สามารถช่วยสรุป Status เตือนงานที่เสี่ยงหลุด รวบรวมข้อมูล หรือเตรียม Decision Brief ให้ Manager ได้ โดยที่ Manager ไม่ต้องทักหาคนสิบคนทุกเช้า แต่สามารถใช้เวลาไปคุยกับสองคนที่มีปัญหาจริงแทน นี่คือการใช้ Technology เพื่อเพิ่ม Management Capacity ไม่ใช่เพิ่ม Notification และเรื่องเดียวกันใช้กับ AI Governance ด้วย หากบริษัทมี Policy 40 หน้าแต่ไม่มีใครอ่าน และ Tool ที่องค์กรอนุมัติใช้ยากมาก คนก็จะกลับไปใช้ Account ส่วนตัวเหมือนเดิม Governance ที่ดีจึงควรตอบคำถามให้คนทำงานได้ทันทีว่า ข้อมูลประเภทไหนใช้กับ AI ได้ อะไรห้ามใช้ ระบบไหนได้รับอนุมัติ ต้อง Mask ข้อมูลเมื่อไร เคสไหนต้องขอ Approval และถ้าไม่แน่ใจควรถามใคร Governance ที่ดีไม่ควรทำให้คนหยุดใช้ AI แต่ควรทำให้คน ใช้ AI ได้เร็วโดยไม่สร้างความเสี่ยงที่ตัวเองไม่รู้ตัว
บางครั้งปัญหาไม่ได้อยู่ที่ทำงานช้า แต่อยู่ที่ผู้บริหารไม่ยอมเลือกว่าจะ “ไม่ทำอะไร”
นี่อาจเป็นประเด็นที่สำคัญที่สุดอีกเรื่องหนึ่ง เพราะเมื่อ Task เพิ่มขึ้น หลายองค์กรพยายามใช้ AI เพื่อทำให้ทุกอย่างเร็วขึ้น แต่คำถามคือ ทุกอย่างจำเป็นต้องถูกทำจริงหรือไม่ บางองค์กรมี Priority 12 เรื่องในเวลาเดียวกัน ทุก Project ถูกเรียกว่าสำคัญ ทุก Request ถูกเรียกว่าด่วน และทุกฝ่ายอยากให้เรื่องของตัวเองขึ้นก่อน จากนั้นก็หวังว่า AI จะช่วยให้พนักงานทำทั้ง 12 เรื่องได้ทัน แต่บางครั้ง Solution ที่ถูกต้องไม่ใช่ “ทำทั้ง 12 เรื่องให้เร็วขึ้น” แต่อาจเป็น “เลือกให้เหลือ 5 เรื่องที่สำคัญจริง” นี่ไม่ใช่ปัญหาของ Technology แต่เป็นเรื่องของ Strategy และ Leadership AI ช่วย Execute สิ่งที่เราเลือกได้ดีขึ้น แต่ไม่สามารถแก้ปัญหาที่ผู้บริหารไม่ยอมเลือก Priority แทนเราได้ทั้งหมด
สุดท้าย AI ไม่ได้แก้ความยุ่งขององค์กรโดยอัตโนมัติ
AI ช่วยได้มากจริง ทั้งลดงานซ้ำ ประมวลผลข้อมูล สรุป ค้นหา เตือน และช่วยให้คนมีเวลาไปทำงานที่สำคัญกว่าเดิม แต่ถ้าองค์กรยังมี Task ที่ไม่มี Owner, Priority ไม่ชัด, ข้อมูลไม่มี Source, Manager ใช้การตามงานแทนระบบ และพนักงานส่งข้อมูลจริงเข้า AI โดยไม่มี Governance สิ่งที่เกิดขึ้นอาจไม่ใช่องค์กรที่ฉลาดขึ้น มันอาจเป็นเพียงองค์กรที่ ประมวลผลความยุ่งได้เร็วขึ้น และบางครั้งความเร็วนั้นก็มาพร้อมกับ Risk ใหม่ที่เมื่อก่อนยังไม่มีด้วย ดังนั้นคำถามที่ผมคิดว่าผู้บริหารควรถามก่อนเรื่อง “เราใช้ AI มากพอหรือยัง?” อาจเป็นคำถามพื้นฐานกว่านั้นว่า ก่อนให้ AI ช่วยเรา เราจัดระบบงาน ข้อมูล และสิทธิ์ในการใช้ข้อมูลดีพอแล้วหรือยัง เพราะอนาคตของการทำงานคงไม่ใช่การเลือกระหว่างคนกับ AI แต่เป็นการออกแบบให้คนรู้ว่าต้องตัดสินใจอะไร ระบบมองเห็นว่างานอยู่ตรงไหน ข้อมูลมีที่มาชัดเจน และ AI ถูกใช้กับข้อมูลในระดับที่เหมาะสมกับความเสี่ยง ถ้าสี่เรื่องนี้ยังไม่ชัด ปัญหาที่ต้องแก้อาจยังไม่ใช่เรื่อง AI ก่อนเลย แต่อาจเป็นเรื่องพื้นฐานกว่านั้นมากว่า องค์กรของเรามีระบบบริหารงานและข้อมูลที่ดีพอแล้วหรือยัง ก่อนจะนำเทคโนโลยีที่เร็วกว่าเดิมเข้ามาขยายทุกอย่างให้เร็วขึ้นอีก
Tags: OperationalMess, PriorityManagement, CoordinationCost, ManagementSystem, DataProvenance, DataLiteracy, ShadowAI, PrivacyByDesign, DataMinimization, AIGovernance, SourceOfTruth, WorkSystemDesign, AIAdoption, ExeRoot, SpaceRoot