ข้อมูลรั่วไม่ได้เริ่มจาก “โดนแฮก” เสมอไป บางครั้งมันเริ่มจากคนที่แค่อยากทำงานให้เร็วขึ้น
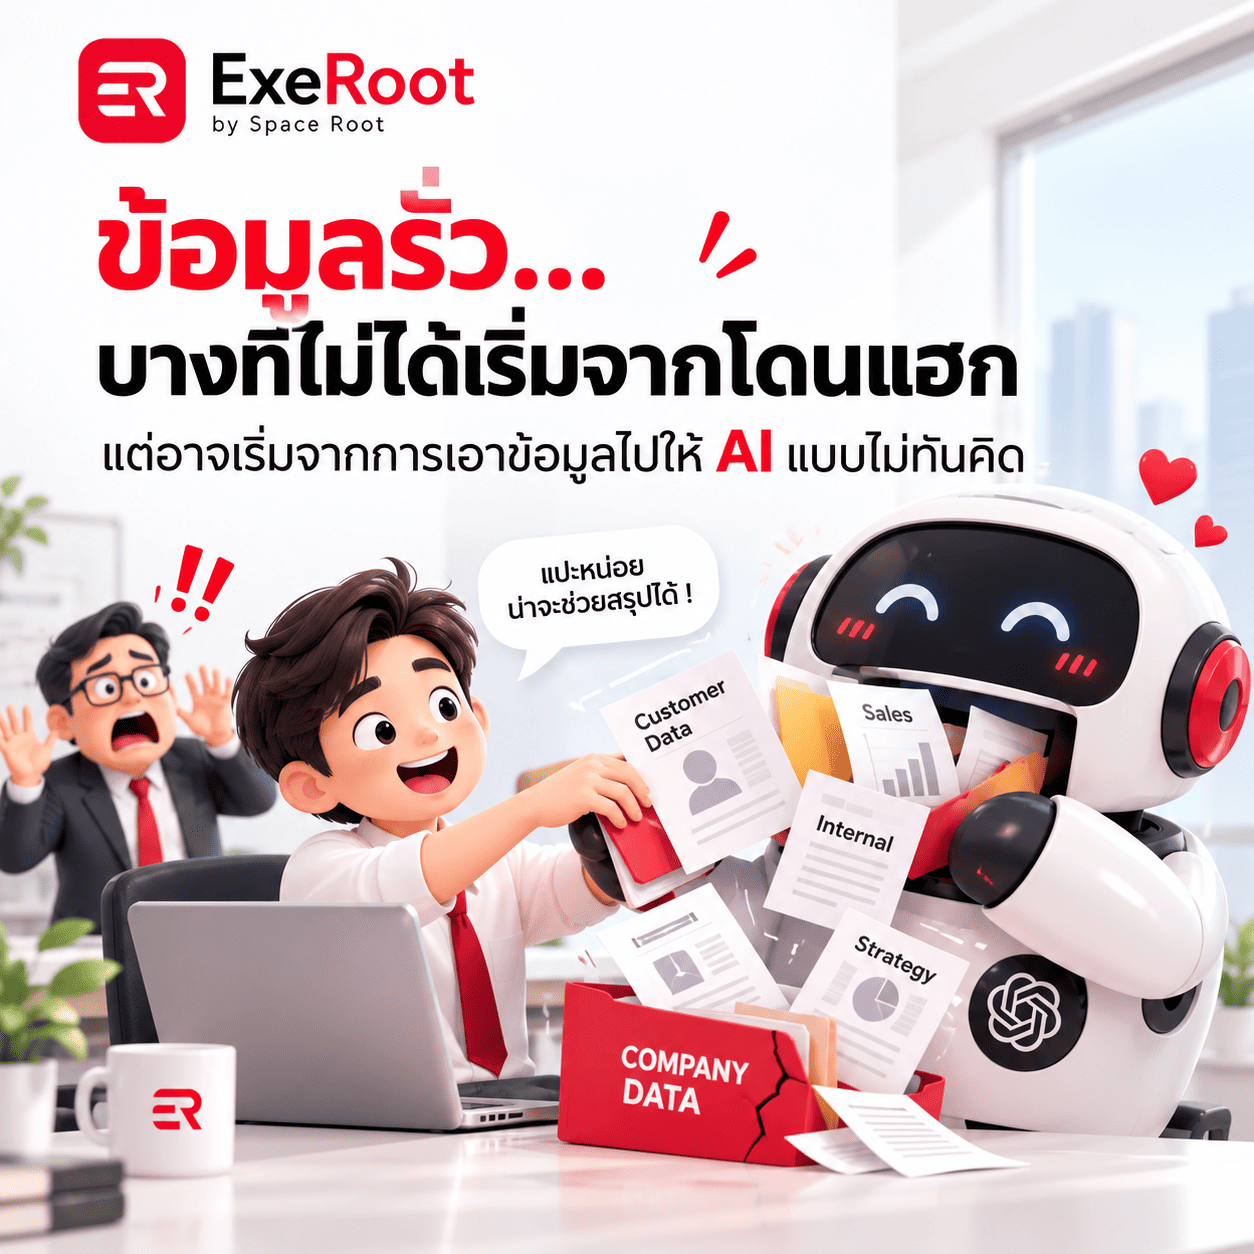
เวลาพูดถึง Cybersecurity หรือ Data Leakage ภาพแรกที่คนส่วนใหญ่นึกถึงมักเป็นเรื่องใหญ่ เช่น ระบบถูกเจาะ Password หลุด Ransomware หรือ Database ถูกขโมยออกไปจากบริษัท เหตุการณ์เหล่านี้เป็นความเสี่ยงจริงและองค์กรจำเป็นต้องป้องกัน แต่ในโลกการทำงานที่ AI เข้ามาอยู่ใกล้พนักงานมากขึ้น ผมคิดว่ามีความเสี่ยงอีกแบบหนึ่งที่น่ากังวลไม่แพ้กัน เพราะมันไม่ได้เกิดจาก Hacker และไม่ได้เกิดจากพนักงานที่มีเจตนาจะขโมยข้อมูลด้วยซ้ำ มันเกิดจากคนที่กำลังพยายามทำงานให้เร็วขึ้น พนักงานอาจ Copy ข้อมูลลูกค้าไปให้ AI ช่วยวิเคราะห์ Manager อาจ Upload Excel เงินเดือนเพื่อหาความผิดปกติ Recruiter อาจส่ง Resume ผู้สมัครจำนวนมากให้ระบบภายนอกช่วยสรุป Sales อาจนำ Meeting Transcript ที่มีข้อมูลของลูกค้าไปให้ AI ช่วยทำ Proposal หรือ Finance อาจส่งตัวเลขภายในเข้าไปถามว่า “ถ้าบริษัทต้องลดต้นทุน ควรเริ่มตรงไหน” คนที่ทำสิ่งเหล่านี้ไม่ได้คิดว่าตัวเองกำลังทำข้อมูลรั่ว เขากำลังคิดเพียงว่าเครื่องมือนี้ช่วยประหยัดเวลาได้มาก และนี่คือเหตุผลที่ Data Leakage ในยุค AI จัดการยากขึ้น เพราะมันสามารถเกิดจากคนทำงานดีที่ใช้เครื่องมือผิดบริบทได้โดยไม่รู้ตัว
ขอบเขตขององค์กรไม่ได้ชัดเหมือนเมื่อก่อนแล้ว
เมื่อก่อนเรื่อง Security ค่อนข้างมองเห็นขอบเขตได้ง่าย ข้อมูลอยู่ใน Server บริษัท ไฟล์อยู่ใน Shared Drive Email อยู่ในระบบองค์กร และ IT เป็นคนควบคุมว่าใครเข้าถึงอะไรได้บ้าง แต่วันนี้ข้อมูลไม่ได้อยู่ในพื้นที่เหล่านั้นเพียงอย่างเดียวอีกต่อไป มันเดินผ่าน Cloud, SaaS, Mobile Application, Messaging App, AI Tool, Browser Extension รวมถึง Account ส่วนตัวที่พนักงานสมัครใช้เอง เพราะฉะนั้นคำถามว่า “ข้อมูลของเราอยู่ที่ไหน?” อาจไม่เพียงพออีกแล้ว เราต้องเริ่มถามด้วยว่า ข้อมูลของเราเคยผ่านที่ไหนมาบ้าง ไฟล์ต้นฉบับอาจยังอยู่ใน Drive ของบริษัทอย่างเรียบร้อย แต่เนื้อหาบางส่วนอาจถูก Copy ไปอยู่ใน Prompt บางส่วนอยู่ใน Chat History บางส่วนถูก Download ลงเครื่องส่วนตัว และบางส่วนอาจถูกส่งต่อผ่านช่องทางอื่นจนไม่มีใครรู้แล้วว่า Version ไหนอยู่ที่ไหนบ้าง ปัญหานี้ไม่ได้หมายความว่าข้อมูลหาย แต่หมายความว่าข้อมูลกระจายตัวจนองค์กรเริ่มควบคุมยาก ซึ่งก็คือปัญหา Data Sprawl ในอีกมิติหนึ่ง และเมื่อข้อมูลกระจายมากขึ้น ความเสี่ยงก็ไม่ได้อยู่เฉพาะวันที่ข้อมูลถูกเผยแพร่ต่อสาธารณะเท่านั้น แค่ข้อมูลถูกส่งไปอยู่ในระบบหรือไปอยู่กับบุคคลที่ไม่ควรได้รับข้อมูลนั้น ก็เริ่มเป็นประเด็นด้าน Governance แล้ว ลองนึกถึง Employee Database ที่มีชื่อ อีเมล เบอร์โทร Salary, Performance Rating และข้อมูล Career ถ้าพนักงาน Export ทั้งไฟล์ไปให้ AI ช่วยวิเคราะห์ว่าใครมีแนวโน้มลาออก ต่อให้ไม่มีข้อมูลชุดนั้นถูกโพสต์บน Internet เลย เราก็ยังต้องถามอยู่ดีว่า จำเป็นต้องใช้ข้อมูลทั้งหมดหรือไม่ คนที่นำข้อมูลไปใช้มีสิทธิ์ทำแบบนั้นหรือไม่ ระบบปลายทางเก็บ Prompt และ Output ไว้นานแค่ไหน มีผู้ให้บริการรายอื่นเกี่ยวข้องหรือไม่ และข้อมูลอาจถูกนำไปใช้เพื่อวัตถุประสงค์อื่นอย่างไร ดังนั้นประโยคว่า “ข้อมูลไม่ได้หลุดไปไหนครับ แค่เอาให้ AI ช่วยวิเคราะห์” อาจยังไม่ใช่คำตอบที่เพียงพอในมุมของ Data Governance
AI ทำให้การย้ายข้อมูลออกจากระบบง่ายจนเราแทบไม่รู้สึกตัว
เมื่อก่อนถ้าจะเอาข้อมูลจำนวนมากออกจากบริษัท เราอาจต้อง Export File ใส่ USB ส่ง Email หรือ Upload เข้าเว็บไซต์ ขั้นตอนเหล่านี้อย่างน้อยทำให้เรารู้สึกว่า “กำลังย้ายข้อมูลออกไป” แต่วันนี้บางครั้งเราเพียง Select All, Copy, Paste แล้วกด Enter ภายในไม่กี่วินาที ข้อมูลหลายพันบรรทัดก็ไปอยู่ในระบบอีกแห่งแล้ว สิ่งที่เปลี่ยนไม่ใช่แค่ Technology แต่คือ Friction ลดลงอย่างมาก และเมื่อการกระทำบางอย่างง่ายขึ้น พฤติกรรมนั้นก็จะเกิดบ่อยขึ้นตามธรรมชาติ คนไม่ได้ระมัดระวังน้อยลงเพราะไม่สนใจ Security แต่เครื่องมือทำให้การกระทำที่ควรหยุดคิดก่อนสักนิด เกิดขึ้นได้เร็วเกินไป นี่คือเหตุผลที่ Security Awareness แบบเดิมที่บอกเพียงว่า “อย่าส่งข้อมูลออกนอกบริษัท” เริ่มไม่เพียงพอ เพราะคนใช้งานไม่ได้รู้สึกว่าตัวเองกำลังส่งข้อมูลออก เขาเพียงรู้สึกว่ากำลังถามเครื่องมือทำงานอีกตัวหนึ่งเท่านั้น
ปัญหาหนึ่งที่ใหญ่กว่านั้นคือ พนักงานจำนวนมากไม่รู้ว่าอะไรถือเป็น “ข้อมูลสำคัญ”
ถ้าถามว่าควรส่ง Password ให้คนอื่นหรือไม่ คำตอบค่อนข้างชัดเจน แต่ถ้าถามว่า Customer List ส่งเข้า AI ได้หรือเปล่า Meeting Transcript ล่ะ Resume Candidate, Forecast, Complaint, Pricing Model หรือรายชื่อลูกค้าที่กำลังจะต่อสัญญา คนเริ่มลังเลทันที นี่คือเหตุผลที่ Data Classification สำคัญมาก ถ้าองค์กรไม่มีภาษากลางว่าข้อมูลประเภทไหนมีความอ่อนไหวระดับใด แต่ละคนก็จะใช้ Judgment ของตัวเอง คนหนึ่งมองว่า Excel นี้เป็นข้อมูลทั่วไป อีกคนคิดว่า Confidential ขณะที่อีกคนเห็นว่าไม่มีเลขบัตรประชาชนจึงน่าจะส่งได้ สุดท้าย Policy เดียวกันกลับถูกตีความต่างกันไปตามคนใช้ และผมคิดว่าอีกความเข้าใจหนึ่งที่องค์กรต้องปรับคือ Data Protection ไม่ควรถูกมองเป็นเรื่อง PDPA อย่างเดียว ข้อมูลส่วนบุคคลเป็นส่วนสำคัญ แต่ยังมีข้อมูลประเภทอื่นที่ถ้ารั่วออกไปสามารถสร้างความเสียหายต่อธุรกิจได้อย่างมาก เช่น Pricing Strategy, Cost Structure, Margin, Contract, Product Roadmap, Source Code, Sales Pipeline, แผน M&A หรือ Strategy ที่ยังไม่ได้ประกาศ ข้อมูลเหล่านี้อาจไม่ได้เป็น Personal Data แต่สามารถทำให้บริษัทเสีย Competitive Advantage ได้ทันที ดังนั้นเวลาพูดเรื่อง Data Protection เราต้องคิดทั้ง Privacy Risk และ Business Confidentiality Risk ไปพร้อมกัน
“มีสิทธิ์เปิดดู” ไม่ได้แปลว่า “มีสิทธิ์ส่งต่อไปที่ไหนก็ได้”
นี่เป็นประเด็นที่ผมคิดว่าสำคัญมากในยุค AI Manager มีสิทธิ์ดู Performance ของลูกทีม Recruiter มีสิทธิ์อ่าน Resume ของผู้สมัคร Finance มีสิทธิ์เปิด Payroll และ Sales มีสิทธิ์ดู Contract ของลูกค้า แต่สิทธิ์เหล่านั้นถูกให้มาเพื่อวัตถุประสงค์บางอย่าง ไม่ได้หมายความว่าเจ้าของสิทธิ์สามารถนำข้อมูลไปประมวลผลผ่านเครื่องมืออะไรก็ได้ตามสะดวก การเข้าถึงข้อมูลกับการนำข้อมูลไปใช้ต่อเป็นคนละเรื่องกัน ตรงนี้เกี่ยวข้องกับแนวคิดอย่าง Purpose Limitation และ Least Privilege คือใช้ข้อมูลเท่าที่จำเป็น เข้าถึงเท่าที่จำเป็น และใช้เพื่อวัตถุประสงค์ที่ชัดเจน ยิ่ง AI ทำให้การนำข้อมูลไปประมวลผลใหม่ง่ายขึ้น หลักการเหล่านี้ยิ่งมีความสำคัญมากขึ้นตามไปด้วย ผมคิดว่าประโยคหนึ่งที่องค์กรควรระวังมากคือ “ลองเอาข้อมูลจริงเข้าไปดูก่อน จะได้เห็นผลจริง” เพราะช่วงทดลองนี่เองมักเป็นช่วงที่ Governance อ่อนที่สุด ระบบยังไม่ได้เข้า Procurement ยังไม่ผ่าน Security Review ยังไม่มี Contract และบางครั้งยังไม่มี Owner ชัดเจน แต่ข้อมูลจริงกลับถูกส่งเข้าไปแล้ว ก่อนใช้ข้อมูลจริงกับ AI Use Case ใหม่ อาจต้องหยุดถามสักนิดว่า จำเป็นจริงหรือไม่ ใช้ Sample Data ได้หรือเปล่า Anonymize หรือ Mask ได้ไหม และมี Field ไหนที่สามารถตัดออกก่อนได้บ้าง
Data Minimization ไม่ควรเป็นเรื่องของฝ่าย Security อย่างเดียวอีกต่อไป
ต่อจากเรื่องนี้ ผมคิดว่า Data Minimization จะกลายเป็นทักษะพื้นฐานของคนทำงานทั่วไปมากขึ้นเรื่อย ๆ ถ้าต้องการให้ AI ช่วยจัดกลุ่ม Feedback ลูกค้า เราจำเป็นต้องส่งชื่อ เบอร์โทร เลขสมาชิก ที่อยู่ และประวัติการซื้อทั้งหมดจริงหรือไม่ หากเป้าหมายคือดู Theme ของ Complaint บางทีเราอาจต้องการเพียงข้อความที่ตัดข้อมูลระบุตัวบุคคลออกแล้วก็เพียงพอ ในทำนองเดียวกัน ถ้าต้องการวิเคราะห์ Performance ระดับทีม อาจไม่จำเป็นต้องส่งชื่อพนักงานทุกคนเข้าไปด้วย หลักคิดง่ายมากคือ ถ้าข้อมูลนั้นไม่จำเป็นต่อคำถาม ก็ไม่ควรถูกส่ง ข้อดีคือไม่เพียงช่วยลด Privacy และ Security Risk แต่บางครั้งยังทำให้ Analysis ดีขึ้นด้วย เพราะข้อมูลที่ไม่ได้เกี่ยวข้องกับคำถามก็เป็น Noise เช่นกัน
Shadow AI กำลังกลายเป็นเรื่องปกติเร็วกว่าที่หลายองค์กรคิด
เมื่อก่อน IT กังวลเรื่อง Shadow IT เพราะพนักงานสมัคร SaaS เอง วันนี้โจทย์กำลังขยับไปสู่ Shadow AI พนักงานแต่ละคนอาจมี AI Account หลายตัว ใช้ฟรีบ้าง จ่ายเงินเองบ้าง ใช้ Browser Extension หรือ Plugin หลายประเภท แล้วนำข้อมูลบริษัทเข้าไปทำงานตามความถนัดของตัวเอง ปัญหาคือองค์กรอาจไม่มี Inventory ด้วยซ้ำว่าข้อมูลของตัวเองกำลังวิ่งผ่าน AI Provider กี่ราย และเรื่องนี้แก้ด้วยการ “ห้าม” อย่างเดียวได้ยาก เพราะแรงจูงใจของคนทำงานตรงไปตรงมามาก ถ้า Tool ของบริษัทใช้เวลา 2 ชั่วโมง แต่วิธีที่เขาหาเองช่วยให้เสร็จภายใน 15 นาที คนจำนวนมากย่อมเลือกสิ่งที่ช่วยให้ส่งงานทัน ดังนั้นการลด Shadow AI ต้องมีทั้ง Control และ Usability ทางที่ปลอดภัยต้องใช้ง่ายพอที่จะเป็นทางเลือกจริง ไม่อย่างนั้นองค์กรเพียงผลักการใช้งานเหล่านั้นให้หลบไปอยู่ในพื้นที่ที่มองไม่เห็นมากกว่าเดิม Security ที่ดีจึงไม่ควรทำให้ “ทางที่ปลอดภัย” เป็นทางที่ทำงานยากที่สุด หากการใช้ AI ที่ได้รับอนุมัติต้องผ่าน Form หลายชุด รอ IT รอ Legal และรอ Security เป็นสัปดาห์ ขณะที่สมัคร Tool ข้างนอกใช้เวลาไม่ถึงหนึ่งนาที เราก็พอจะเดาได้ว่าพฤติกรรมจริงจะไปทางไหน Governance ที่ใช้ได้จริงต้องมี Approved Tool ที่ชัด Data Classification ที่เข้าใจง่าย มีกฎว่าอะไร Copy ได้หรือไม่ได้ มีวิธี Mask Data และมีช่องทางถามคำถามที่ได้คำตอบเร็ว นี่คือ Security by Design มากกว่า Security by Warning
ข้อมูลไม่ได้เสี่ยงเฉพาะตอนส่งเข้า AI เท่านั้น Output ก็สามารถสร้างปัญหาได้เหมือนกัน
เรื่องนี้ไม่ค่อยถูกพูดถึงเท่าที่ควร สมมติ AI สรุปข้อมูล Salary ของพนักงานหลายคนแล้วสร้าง Report ใหม่ จากนั้น Report ถูก Copy เข้า Chat Group ที่มีคนจำนวนมากกว่ากลุ่มที่ควรเห็นข้อมูลต้นทาง หรือ AI สรุป Customer Complaint แล้วใส่ชื่อและข้อมูลลูกค้าลงใน Presentation โดยไม่ได้ตั้งใจ ข้อมูลแบบนี้เรียกได้ว่าเป็น Derived Data คือข้อมูลใหม่ที่ถูกสร้างขึ้นจากข้อมูลต้นทาง แม้หน้าตาจะไม่เหมือนข้อมูลต้นฉบับ แต่ความอ่อนไหวอาจเท่าเดิม หรือในบางกรณีสูงกว่าเดิมเสียอีก เพราะ AI สามารถนำข้อมูลหลายส่วนมาประกอบกันจนสร้าง Insight ที่แต่เดิมไม่มีใครเห็นได้ง่าย ๆ เพราะฉะนั้น Data Classification ไม่ควรหายไปทันทีหลังข้อมูลผ่าน AI แล้ว ถ้า Input Sensitive Output ก็อาจ Sensitive ตามไปด้วย
AI ยังทำให้ Access Control ที่ไม่ดีสร้างผลกระทบได้เร็วขึ้น
Permission Problem หลายอย่างมีอยู่ก่อน AI แล้ว พนักงานย้ายทีมแต่สิทธิ์เก่ายังอยู่ Manager เปลี่ยน Role แต่ยังเห็น Folder เดิม Vendor จบ Project แต่ Account ไม่ถูกปิด หรือ Shared Link ถูกตั้งเป็น “Anyone with the link” มานานหลายปี เรื่องเหล่านี้ไม่ได้ดูน่ากลัวเหมือน Hacker แต่เป็นช่องโหว่จริง สิ่งที่ AI เปลี่ยนคือ จากเดิมคนต้องรู้ก่อนว่าไฟล์อยู่ตรงไหนถึงจะหาเจอ วันนี้เขาอาจเพียงถาม AI Assistant ว่า “ช่วยหาข้อมูล Compensation ของ Project นี้ทั้งหมด” แล้วระบบค้นหาและสรุปให้ภายในไม่กี่วินาที ดังนั้นคำว่า “เขาเปิดได้อยู่แล้ว” อาจต้องถูกคิดใหม่ เพราะความสามารถในการเปิดไฟล์ทีละไฟล์ไม่เท่ากับความสามารถในการให้ AI ประมวลข้อมูลจากหลายพันไฟล์พร้อมกัน Technology กำลังเปลี่ยนสิ่งที่เรียกว่า Effective Access แม้ Permission บนกระดาษจะยังเหมือนเดิมก็ตาม
เมื่อข้อมูลผิดที่ผิดทาง Incident Response ต้องพร้อมก่อนเกิดเหตุ
ถ้าพนักงานเผลอส่งข้อมูล Sensitive เข้า AI ภายนอก สิ่งที่องค์กรไม่ควรเพิ่งมาถามวันนั้นคือ “แล้วเราต้องทำอะไรต่อ?” ควรรู้ล่วงหน้าว่าใครเป็นจุดรับแจ้ง ต้องหยุด Access หรือไม่ ติดต่อ Provider อย่างไร ต้องประเมินข้อมูลประเภทไหน มี Log เพียงพอหรือไม่ ต้องแจ้งใครภายใน และมีประเด็นทางกฎหมายหรือ Contract อะไรที่เกี่ยวข้อง Incident Response ไม่ควรถูกออกแบบเฉพาะกรณี Server ถูกโจมตีจากภายนอก Human Error และ AI Misuse ก็ควรถูกนำเข้า Scenario ด้วยเช่นกัน และอีกช่วงหนึ่งที่ควรระวังคือช่วง Offboarding ไม่ใช่เพราะพนักงานทุกคนจะขโมยข้อมูล แต่เพราะหลายพฤติกรรมเกิดขึ้นโดยคนไม่รู้สึกว่าตัวเองกำลังทำผิด เช่น ส่งผลงานไป Personal Email เพื่อเก็บ Portfolio เก็บ Contact ลูกค้า Download Presentation ที่ตัวเองสร้าง หรือเก็บ Prompt และ Knowledge Base ไว้ใน Account ส่วนตัว คนอาจคิดว่า “นี่คืองานที่ผมทำเอง” แต่ภายในงานนั้นอาจมีข้อมูลบริษัท ลูกค้า หรือบุคคลอื่นปะปนอยู่ ดังนั้น Offboarding ในยุคใหม่จึงไม่ควรจบที่คืน Laptop และปิด Email แต่ต้องมอง Digital Footprint ที่กระจายตามเครื่องมือต่าง ๆ ด้วย
Data Leakage ไม่ใช่งานของ IT ฝ่ายเดียว
ผมคิดว่านี่เป็นเรื่องที่องค์กรต้องเปลี่ยนวิธีคิดมากที่สุดเรื่องหนึ่ง IT ดูแล Infrastructure ได้ Security วาง Control ได้ Legal ช่วยเรื่องข้อกำหนด และ Data Protection ช่วยเรื่อง Privacy ได้ แต่คนที่หยิบข้อมูลขึ้นมาใช้จริงทุกวันคือ Sales, Finance, People, Marketing, Operation และ Manager ดังนั้น Data Protection ต้องค่อย ๆ กลายเป็น Management Discipline หัวหน้าต้องรู้ว่าทีมใช้เครื่องมืออะไร Owner ของ Process ต้องเข้าใจว่าข้อมูลใดถูกนำไปใช้ ผู้บริหารต้องรู้ว่าความเร็วที่เพิ่มขึ้นแลกมากับ Risk แบบไหน และพนักงานต้องเข้าใจว่า Security ไม่ใช่งานที่เกิดขึ้นหลังทำงานเสร็จ แต่เป็นส่วนหนึ่งของวิธีทำงานตั้งแต่ต้น ผมไม่คิดว่าพนักงานทุกคนต้องกลายเป็นผู้เชี่ยวชาญ Cybersecurity แต่ควรมีนิสัยพื้นฐานก่อนส่งข้อมูลเข้า AI เช่นหยุดคิดว่าข้อมูลนี้เป็นของใคร จำเป็นต้องส่งทั้งหมดหรือไม่ มี Personal หรือ Confidential Data อยู่หรือเปล่า Tool ที่กำลังใช้ผ่านการอนุมัติหรือไม่ และถ้าข้อมูลชุดนี้หลุดไปอยู่กับคนอื่น ผลกระทบที่ตามมาคืออะไร คำถามง่าย ๆ แบบนี้อาจช่วยลด Mistake ได้มากกว่าที่คิด เพราะ Data Leakage หลายครั้งไม่ได้เกิดจากเทคโนโลยีซับซ้อน แต่เกิดจากช่วงไม่กี่วินาทีก่อนกด Send ที่ไม่มีใครหยุดคิดเลย
เป้าหมายจึงไม่ใช่ทำให้ข้อมูล “ออกจากบริษัทไม่ได้”
ในโลกจริงเป็นไปไม่ได้อยู่แล้ว องค์กรยังต้องใช้ Cloud ต้องทำงานกับ Vendor ต้องส่งข้อมูลให้ Partner ต้องใช้ AI และต้องเชื่อมระบบเข้าหากัน เป้าหมายของ Data Security จึงควรเป็นการทำให้ข้อมูล เคลื่อนที่อย่างมีการควบคุม องค์กรควรรู้ว่าข้อมูลไปไหน ไปเพื่ออะไร ใครมองเห็นได้ อยู่ที่นั่นนานเท่าไร และใครรับผิดชอบ หากตอบคำถามเหล่านี้ได้ เราจะเริ่มเปลี่ยนจากการ “กลัวว่าข้อมูลจะรั่ว” ไปสู่การบริหาร Data Risk อย่างเป็นระบบมากขึ้น
และสุดท้าย ผมคิดว่าข้อมูลรั่วที่น่ากลัวที่สุดอาจไม่ใช่ข้อมูลที่ขึ้นข่าว
เพราะ Hacker เจาะระบบ อย่างน้อยเรายังรู้ว่านั่นคือ Security Incident แต่ข้อมูลที่พนักงาน Copy เข้า AI Account ส่วนตัว Upload เข้าเว็บฟรี แชร์ผ่าน Public Link หรือเก็บไว้ใน Account ของคนที่ลาออกไปแล้ว อาจอยู่นอกขอบเขตขององค์กรเป็นเดือนหรือเป็นปีโดยไม่มีใครรู้ ตรงนี้คือความแตกต่างระหว่าง Data Breach กับ Data Governance Failure อย่างหนึ่งเป็นเหตุการณ์ที่มองเห็นได้ แต่อีกอย่างคือระบบการทำงานที่ปล่อยให้ข้อมูลเดินทางไปเรื่อย ๆ โดยองค์กรไม่เคยมองเห็นเส้นทางนั้นเลย ดังนั้นก่อนที่ผู้บริหารจะถามเพียงว่า “ปีนี้เราจะให้คนใช้ AI มากขึ้นอย่างไร?” ผมคิดว่าควรมีอีกคำถามอยู่ข้าง ๆ กันเสมอว่า “เรารู้หรือยังว่าข้อมูลของบริษัทกำลังเดินทางไปไหนบ้างระหว่างที่ทุกคนใช้ AI ทำงาน?” เพราะ AI สามารถทำให้ Productivity เพิ่มขึ้นอย่างมาก แต่ถ้าความเร็วของการใช้งานโตเร็วกว่าความสามารถขององค์กรในการควบคุมข้อมูล สิ่งที่โตตาม Productivity อาจไม่ได้มีเพียง Business Value Business Risk ก็สามารถโตตามไปอย่างเงียบ ๆ ได้เหมือนกัน
Tags: DataLeakage, AIDataSecurity, DataGovernance, DataClassification, DataMinimization, PurposeLimitation, LeastPrivilege, ShadowAI, SecurityByDesign, DerivedData, EffectiveAccess, IncidentResponse, SecureOffboarding, ExeRoot, SpaceRoot