ป้องกันข้อมูลรั่วอย่างไร ในวันที่ “ห้ามพนักงานใช้ AI” แทบเป็นไปไม่ได้แล้ว
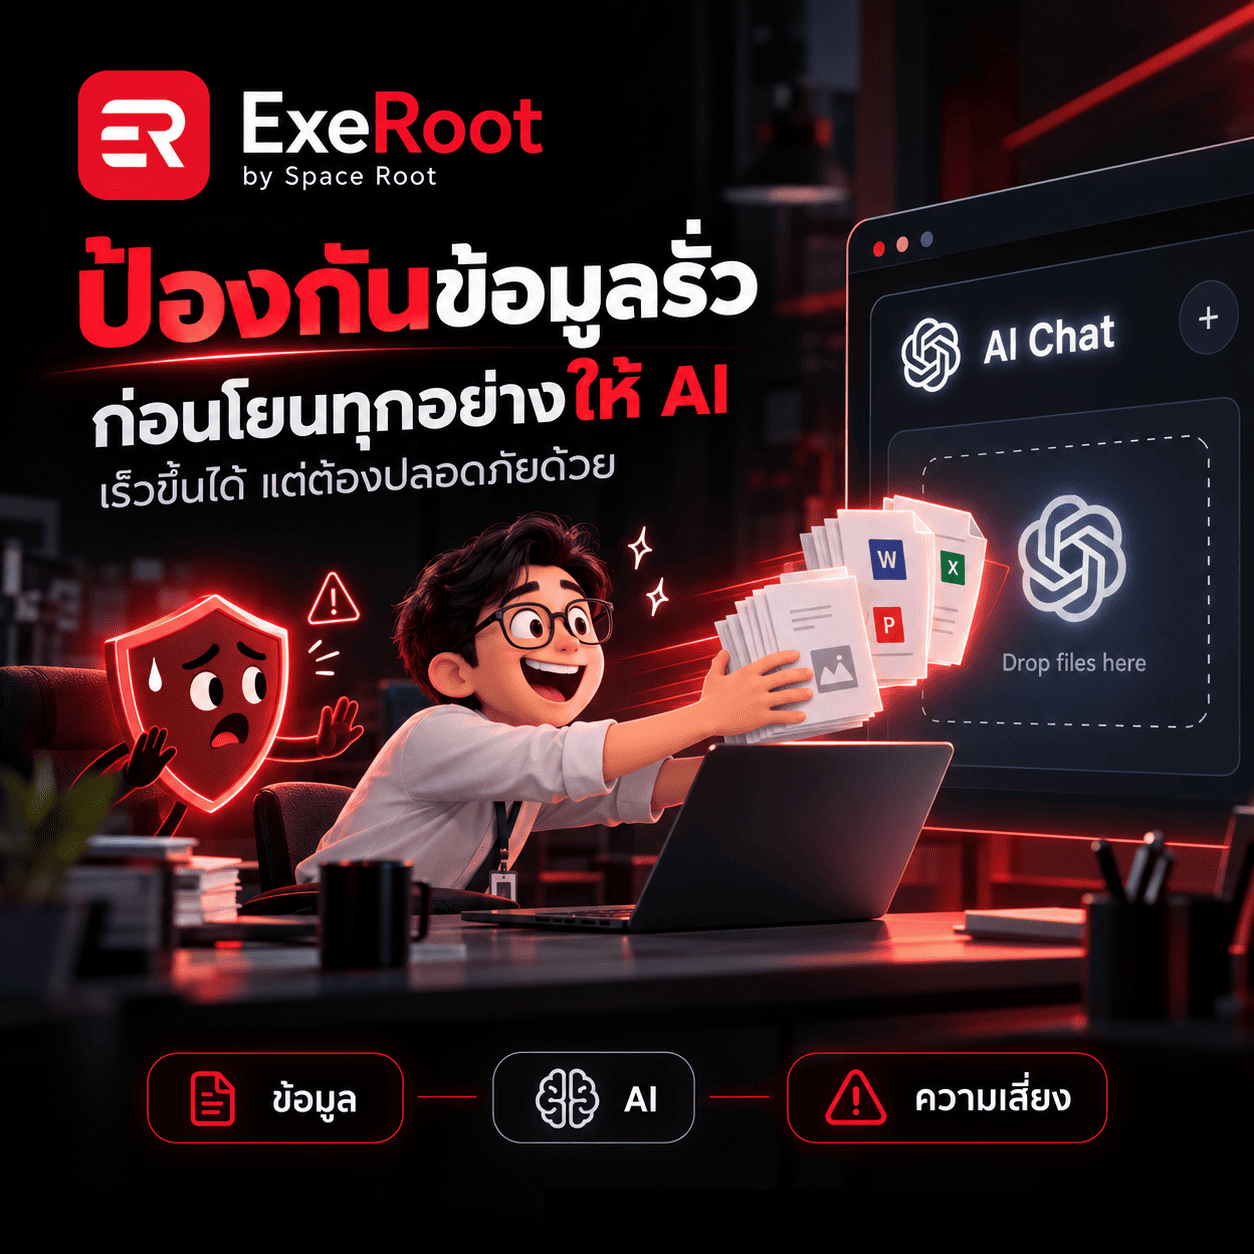
ช่วงนี้เวลาพูดถึงเรื่องข้อมูลรั่ว หลายคนยังนึกถึงภาพของ Hacker เจาะระบบ ฐานข้อมูลถูกขโมย หรือไฟล์สำคัญหลุดออกจาก Server ของบริษัท แต่ในความเป็นจริง ความเสี่ยงรูปแบบใหม่อาจเกิดขึ้นเงียบกว่านั้นมาก และบางครั้งคนที่ทำให้ข้อมูลออกไปจากระบบก็ไม่ได้มีเจตนาร้ายเลยด้วยซ้ำ พนักงานกำลังทำ Report แล้ว Copy ข้อมูลลูกค้าเข้า AI เพื่อให้ช่วยสรุป Recruiter เอา Resume จำนวนมากไปให้ช่วยจัดกลุ่ม Manager ส่งข้อมูล Performance ของทีมไปถามว่าใครมีความเสี่ยงลาออก หรือ Sales เอา Meeting Transcript ของลูกค้าไปให้ AI ช่วยร่าง Proposal ทุกคนกำลังทำสิ่งเดียวกันคือ “พยายามทำงานให้เร็วขึ้น” ไม่ได้คิดว่าตัวเองกำลังสร้าง Data Leakage และนั่นคือเหตุผลว่าทำไมการป้องกันข้อมูลในยุค AI จึงซับซ้อนกว่าการออกประกาศว่า “ห้ามส่งข้อมูลบริษัทออกไปภายนอก” มาก สำหรับคนทำงาน เขาไม่ได้รู้สึกว่ากำลังเอาข้อมูลบริษัทออกไปไหน เขาเพียงรู้สึกว่ากำลังใช้เครื่องมือช่วยทำงานเหมือนใช้ Excel, Google Search หรือ Software อื่น ๆ ถ้าองค์กรยังบริหาร Data Protection ด้วยแนวคิดแบบเดิมอย่างเดียว เราอาจมีกฎเพิ่มขึ้นเรื่อย ๆ แต่ข้อมูลก็ยังไหลออกไป เพียงแต่ไปอยู่ในพื้นที่ที่องค์กรเองมองไม่เห็น คำถามจึงไม่ควรหยุดอยู่ที่ว่า “จะห้ามข้อมูลรั่วอย่างไร” แต่ควรเปลี่ยนเป็นว่า เราจะออกแบบวิธีทำงานอย่างไรให้พนักงานยังใช้ AI และข้อมูลได้อย่างมีประสิทธิภาพ โดยไม่สร้างความเสี่ยงที่องค์กรไม่รู้ตัว
การป้องกัน 100% แทบเป็นไปไม่ได้ เป้าหมายจริงคือควบคุมการเคลื่อนที่ของข้อมูลให้ได้
เวลาเกิด Incident ผู้บริหารมักถามว่า ทำไมระบบไม่ Block ทำไม Security ไม่เตือน หรือทำไมพนักงานถึงยัง Upload ข้อมูลออกไปได้ คำถามเหล่านี้เข้าใจได้ แต่ถ้าคิดให้ลึก ธุรกิจเองก็ไม่สามารถล็อกทุกอย่างจนข้อมูลออกไปไหนไม่ได้เลย เพราะการทำงานปัจจุบันต้องเชื่อมต่อกับลูกค้า Vendor Cloud SaaS และระบบภายนอกจำนวนมากอยู่แล้ว ข้อมูลจึงต้องเคลื่อนที่เป็นเรื่องปกติ ปัญหาไม่ได้อยู่ที่ “ข้อมูลออกจากระบบหรือไม่” อย่างเดียว แต่อยู่ที่ว่า ข้อมูลอะไรออกได้ ออกไปไหน ใครมีสิทธิ์ส่ง ส่งไปเพื่ออะไร และเมื่อเกิดความผิดพลาด เรารู้ตัวเร็วพอหรือไม่ ดังนั้น Data Protection ที่ดีจึงไม่ได้หมายถึง Zero Data Movement แต่เป็น Controlled Data Movement มากกว่า องค์กรต้องยอมรับก่อนว่าความเสี่ยงเป็นส่วนหนึ่งของการทำงาน แล้วบริหารมันอย่างมีระบบ แทนที่จะพยายามสร้างกำแพงที่สูงขึ้นเรื่อย ๆ จนคนทำงานไม่ได้และสุดท้ายต้องหาทางเลี่ยงระบบเอง
ก่อนจะป้องกันข้อมูลรั่ว ต้องรู้ก่อนว่า “ข้อมูลของบริษัทอยู่ที่ไหนบ้าง”
เรื่องนี้ฟังดูพื้นฐาน แต่หลายองค์กรตอบไม่ได้ครบ ถามว่า Customer Data อยู่ที่ไหน หลายคนอาจตอบว่า “อยู่ใน CRM” แต่พอไล่จริง ๆ กลับพบว่ามี Excel Export อยู่ใน Shared Drive มีรายชื่อลูกค้าในเครื่อง Sales มี Google Sheet ที่ทีมทำเพิ่มเอง มีไฟล์แนบอยู่ใน Email มีข้อมูลบางส่วนอยู่ใน Line Group และบางส่วนอาจถูก Copy เข้า AI Chat ไปแล้ว นี่คือเหตุผลที่ Data Inventory ยังเป็นเรื่องสำคัญมาก องค์กรไม่จำเป็นต้องเริ่มด้วยโครงการใหญ่หรือซื้อ Platform แพง ๆ แต่ต้องเริ่มให้รู้ก่อนว่า ข้อมูลสำคัญของบริษัทคืออะไร อยู่ที่ไหน ใครเป็นเจ้าของ ใครใช้ และมีระบบใดบ้างที่สามารถเข้าถึงข้อมูลชุดนั้นได้ เพราะเราไม่สามารถปกป้องสิ่งที่ตัวเองไม่รู้ว่ามีอยู่
และเมื่อรู้ว่ามีข้อมูลอะไรแล้ว ขั้นต่อมาคือรู้ว่า ข้อมูลแต่ละประเภทสำคัญไม่เท่ากัน
หลายบริษัทใช้คำง่าย ๆ ว่า “ข้อมูลบริษัทเป็นความลับ” แต่ถ้าทุกอย่างถูกเรียกว่า Confidential หมด สุดท้ายก็แทบไม่ต่างจากไม่มี Classification เพราะพนักงานไม่รู้ว่ารายงานยอดขายทั่วไปกับข้อมูล Payroll หรือข้อมูลสุขภาพของพนักงานควรถูกดูแลต่างกันอย่างไร องค์กรจึงควรมี Data Classification ที่เข้าใจง่าย ไม่จำเป็นต้องซับซ้อน อาจแบ่งเป็น Public, Internal, Confidential และ Restricted แล้วกำหนดให้ชัดว่าแต่ละระดับแชร์ผ่านช่องทางใดได้ ใครเข้าถึงได้ สามารถส่งเข้า AI ได้หรือไม่ ต้อง Mask หรือ Encrypt หรือเปล่า และควรเก็บนานแค่ไหน เมื่อเรื่องเหล่านี้ชัด คนก็ไม่ต้องใช้ความรู้สึกส่วนตัวตัดสินทุกครั้งว่าข้อมูลชุดไหน “น่าจะส่งได้”
อย่าส่งข้อมูลทั้งหมด เพียงเพราะ AI อ่านได้ทั้งหมด
Generative AI ทำให้เรามีนิสัยใหม่อย่างหนึ่งคือ ถ้าไม่รู้ว่าข้อมูลส่วนไหนสำคัญ ก็โยนทั้งไฟล์เข้าไปแล้วให้ AI ช่วยหาให้ สะดวกครับ แต่ในมุม Data Governance นี่ไม่ใช่พฤติกรรมที่ดีเสมอไป สมมติทีม People ต้องการวิเคราะห์ Pattern การลาออก จริง ๆ แล้วอาจต้องใช้เพียงอายุงาน หน่วยงาน ระดับตำแหน่ง Performance Band และสถานะการลาออก แต่สิ่งที่เกิดขึ้นจริงอาจเป็นการ Export Employee Master ทั้งชุด ซึ่งมีชื่อ เบอร์โทร ที่อยู่ วันเกิด เงินเดือน และข้อมูลอื่นที่ไม่ได้เกี่ยวข้องกับคำถามเลย หลัก Data Minimization จึงสำคัญมากขึ้นในยุค AI ความหมายง่าย ๆ คือ ใช้เท่าที่จำเป็นต่อวัตถุประสงค์นั้น ถ้าข้อมูลบาง Field ไม่ช่วยตอบคำถาม ก็ควรถูกตัดออกตั้งแต่ต้น ทุกข้อมูลที่ไม่ส่งออกไปคือ Risk ที่ลดลง และในหลายกรณี Analysis ยังดีขึ้นด้วย เพราะ Noise ในข้อมูลลดลงตามไปด้วย
องค์กรไม่ควรบอกแค่ “ใช้ AI ได้ แต่ระวังข้อมูลนะ”
ประโยคนี้ฟังดูเหมือนให้ Freedom กับพนักงาน แต่ในทางปฏิบัติคือการโยนภาระการตัดสินใจด้าน Security ไปให้คนทำงานแต่ละคน พนักงานต้องเดาเองว่า AI ตัวไหนปลอดภัย Account ส่วนตัวใช้ได้หรือไม่ Free Version ต่างจาก Corporate Version อย่างไร Browser Extension ตัวนี้เก็บข้อมูลหรือไม่ Prompt ถูกเก็บไว้หรือเปล่า และถ้าแต่ละคนต้องตอบคำถามเหล่านี้เอง คำตอบย่อมไม่เหมือนกัน สิ่งที่บริษัทควรทำมากกว่าคือกำหนด Approved AI Tools ให้ชัดเจน ไม่ได้หมายความว่าต้องบังคับทุกคนใช้ AI ตัวเดียว แต่ต้องทำให้คนรู้ว่าเครื่องมือใดผ่านการตรวจเรื่อง Security, Privacy, Contract และ Data Handling แล้ว ถ้าจะใช้ Tool ใหม่ต้องขออย่างไร และข้อมูลประเภทใดสามารถใช้กับเครื่องมือใดได้บ้าง เพราะถ้าทางที่ถูกต้องยุ่งยากกว่าทางลัดมากเกินไป สุดท้ายคนก็จะเลือกทางลัด นี่เป็นบทเรียนเดียวกับ Shadow IT ในอดีต แต่วันนี้เปลี่ยนเป็น Shadow AI
Policy ที่ดีต้องถูกแปลงให้เป็น “กติกาที่คนใช้ได้ตอนกำลังทำงาน”
ผมเคยเห็น Policy ด้าน Security ที่เขียนดีมาก ถูกต้องทุกข้อ แต่ยาว 30–40 หน้า ปัญหาคือไม่มีพนักงานคนไหนเปิดเอกสารนั้นตอนกำลังจะ Copy Customer Data เข้า AI เขาต้องตัดสินใจภายในไม่กี่วินาที ดังนั้นนอกจาก Policy ฉบับเต็มแล้ว องค์กรควรมี Operational Rule ที่คนเข้าใจได้ทันที เช่น ข้อมูล Public ใช้ได้ตามปกติ ข้อมูล Internal ใช้ได้เฉพาะ Approved Tool ข้อมูลส่วนบุคคลบางประเภทต้อง Mask ก่อน และข้อมูลความเสี่ยงสูงอย่าง Payroll, Health Data, Password, Secret Key, Legal Document หรือ Critical Business Data ต้องผ่านขั้นตอนเพิ่มเติมก่อนนำไปใช้ กฎหมายยังต้องละเอียด Security Standard ก็ยังต้องครบ แต่คนทำงานต้องมี Version ที่พออ่านแล้วตอบตัวเองได้ทันทีว่า “ไฟล์นี้เอาเข้า AI ได้ไหม” ถ้าตอบไม่ได้ Policy ก็ยังไม่ได้ทำหน้าที่ในชีวิตจริง
Access Control แบบเดิมอาจไม่พอ เมื่อ AI สามารถค้นข้อมูลแทนคนได้
เมื่อก่อนเราถามว่า “ใครเปิดไฟล์นี้ได้?” แต่ยุค AI ต้องถามเพิ่มว่า “ใครสามารถให้ AI ค้นหา เชื่อมโยง และสรุปข้อมูลจากไฟล์เหล่านี้ทั้งหมดได้?” สองอย่างนี้ให้ความสามารถไม่เท่ากัน พนักงานคนหนึ่งอาจมีสิทธิ์เปิด 100 Folder อยู่แล้ว แต่ในอดีตแทบไม่มีโอกาสไล่อ่านทั้งหมด วันนี้ AI Assistant สามารถค้นทุก Folder แล้วสรุปคำตอบกลับมาได้ภายในไม่กี่วินาที Permission แบบเดิมที่เคยดูไม่อันตรายมาก จึงอาจกลายเป็นความเสี่ยงที่สูงขึ้นทันทีเมื่อ AI เข้ามาช่วยเพิ่มความสามารถในการค้นหาและเชื่อมโยงข้อมูล นี่ทำให้แนวคิด Least Privilege กลับมาสำคัญกว่าเดิม คนควรเห็นข้อมูลเท่าที่จำเป็นต่อ Role จริง ๆ ไม่ใช่เปิดไว้กว้างเพราะ “เผื่อวันหนึ่งต้องใช้” เพราะในโลกที่มี AI สิ่งที่เคยเป็นเพียง Permission เผื่อไว้ อาจกลายเป็นความสามารถในการรวบรวมข้อมูลระดับที่ไม่เคยมีมาก่อน
Data Governance ไม่ควรถูกโยนให้ IT ดูคนเดียว
ถ้าถามว่า “ใครดูแลข้อมูลลูกค้า?” แล้วคำตอบคือ “IT” อย่างเดียว ผมคิดว่ายังไม่ครบ IT ดูแล Infrastructure ได้ Security ช่วยวาง Control ได้ Legal และ Data Protection ช่วยกำหนดกรอบได้ แต่คนที่รู้ว่าข้อมูลชุดนั้นถูกสร้างมาเพื่ออะไร ใช้ทำอะไร และผลกระทบทางธุรกิจคืออะไร มักเป็น Business Owner Sales ต้องรู้ว่า Customer Data ควรถูกใช้อย่างไร People ต้องเข้าใจ Employee Data Finance ต้องรู้ว่าข้อมูลทางการเงินใดมีความอ่อนไหว ส่วน IT, Security และ Legal เข้ามาช่วยให้การใช้งานอยู่ในกรอบที่เหมาะสม Data Governance จึงเป็นเรื่องร่วมกัน ไม่ใช่โยนข้อมูลทุกอย่างไปให้ IT รับผิดชอบแล้ว Business ใช้ตามสะดวก
ข้อมูลรั่วหลายครั้งเกิดจาก Process มากกว่าเกิดจากระบบถูกเจาะ
ลองดู Workflow ธรรมดา ๆ ในองค์กร Manager ขอ Report พนักงาน Download ข้อมูล ส่งให้เพื่อนช่วยตรวจ เพื่อนเอาเข้า AI เพื่อให้ช่วยสรุป จากนั้น Download Output กลับมา Copy ใส่ PowerPoint แล้วส่งเข้า Group Chat ใน Process เดียว ข้อมูลอาจเดินผ่านระบบห้าหรือหกแห่งแล้ว ถ้าองค์กรดูเฉพาะ Database Security จะมองไม่เห็นความเสี่ยงจำนวนมาก เพราะ Database ต้นทางอาจปลอดภัยมาก แต่ข้อมูลเริ่มเสี่ยงตั้งแต่จุดที่ถูก Export ออกมา นี่คือเหตุผลที่ Data Flow Mapping สำคัญ เราไม่ได้ต้องรู้แค่ว่า Data “เก็บอยู่ที่ไหน” แต่ต้องรู้ด้วยว่า Data “เดินไปไหนบ้างระหว่างทำงาน” เพราะ Data Leakage จำนวนมากเกิดตรงจุดส่งต่อ มากกว่าจุดเก็บข้อมูลหลัก
Privacy และ Security ควรถูกคิดตั้งแต่ตอนออกแบบ Workflow ไม่ใช่ค่อยมาตรวจหลังระบบเสร็จ
สมมติทีมสร้าง Workflow อัตโนมัติที่รับ Email ลูกค้า ส่งให้ AI วิเคราะห์ Sentiment แล้วให้ AI สรุป Complaint ก่อนเปิด Ticket ให้ Service Team ในมุม Productivity ระบบนี้ดูดีมาก แต่ก่อนเปิดใช้จริงควรถามต่อว่า Email ลูกค้ามีข้อมูลส่วนบุคคลอะไรบ้าง จำเป็นต้องส่งเข้า Model ทั้งหมดหรือไม่ Output จะไปเก็บที่ไหน เก็บนานแค่ไหน ใครเปิด Ticket ได้ และมี Sensitive Data ถูก Copy ไปใน Notification หรือไม่ นี่คือแนวคิดของ Privacy by Design Security และ Privacy ไม่ควรเป็นทีมที่มาปรากฏตัวตอน Project ใกล้ Go-live แล้วบอกว่า “อันนี้ทำไม่ได้” แต่ควรถูกคิดอยู่ใน Architecture ตั้งแต่ต้น เพราะระบบที่ออกแบบผิดตั้งแต่ต้นมักแก้ยากและแพงกว่ามาก
Log อาจดูน่าเบื่อ จนถึงวันที่เกิดเหตุขึ้นจริง
วันปกติแทบไม่มีใครสนใจ Log แต่วันหนึ่งถ้าพบว่าข้อมูลลูกค้าถูกส่งเข้า Tool ที่ไม่ได้รับอนุญาต สิ่งแรกที่องค์กรอยากรู้ทันทีคือ ใครส่ง ส่งเมื่อไร ส่งอะไรออกไปจำนวนเท่าไร ใช้ Account ไหน และมีการส่งต่อหรือไม่ ถ้าไม่มี Audit Trail คำตอบทั้งหมดจะกลายเป็นการถามคนจากความทรงจำ Log จึงไม่ได้มีไว้เพื่อจับผิดพนักงานเท่านั้น แต่มันทำให้องค์กรสามารถทำ Incident Investigation และประเมินผลกระทบได้จริง Security ที่ไม่มี Visibility คือ Security ที่เราไม่รู้ด้วยซ้ำว่าระบบที่สร้างไว้ทำงานได้หรือไม่
อย่าหวังว่า DLP หรือ Security Tool ตัวเดียวจะจบทุกเรื่อง
Data Loss Prevention หรือ DLP ช่วยได้มากในการตรวจจับการ Copy, Upload, Email หรือส่งข้อมูลที่มี Pattern บางประเภทออกนอกองค์กร แต่เครื่องมือเหล่านี้มีข้อจำกัดเสมอ ข้อมูลอาจถูก Copy แค่บางส่วน ถูกแปลงรูป ถ่าย Screenshot หรือถูกส่งผ่านช่องทางใหม่ที่ Control ยังไม่ครอบคลุม ดังนั้น DLP ควรเป็น Safety Net ไม่ใช่คำตอบทั้งหมด การป้องกันข้อมูลที่ดีต้องมี People + Process + Technology ทำงานร่วมกัน ไม่มีเครื่องมือใดเครื่องมือหนึ่งสามารถทดแทนอีกสองส่วนได้ทั้งหมด ซึ่งก็คือหลัก Defense in Depth
Security Awareness แบบดูวิดีโอปีละครั้งอาจไม่พอแล้ว
พนักงานอาจเรียน Course Security ผ่าน 90% และตอบ Quiz ได้ทุกข้อ แต่พอเจอสถานการณ์จริงว่า “ลูกค้าส่ง Excel มา ช่วยให้ AI สรุปให้หน่อย” เขาก็ยังไม่รู้ว่าจะทำอย่างไร ผมคิดว่า Training ในยุคนี้ต้องใช้ Scenario มากขึ้น เช่น ถ้ามี Transcript ที่มีชื่อและข้อมูลลูกค้า จะใช้ AI อย่างไร Manager ส่ง Employee Data ที่มี Salary มาขอให้วิเคราะห์ควรทำอย่างไร Vendor ขอข้อมูลไป Test System ควรส่งอะไรได้แค่ไหน หรือพนักงานที่กำลังลาออกอยากเก็บผลงานไว้ทำ Portfolio ทำได้หรือไม่ Scenario ทำให้คนฝึก Judgment และ Judgment สำคัญกว่าการจำ Policy เพราะชีวิตจริงไม่ได้ถามคำถามแบบ Multiple Choice ให้เราตลอดเวลา
อีกเรื่องที่สำคัญคือ ถ้าพลาดแล้วต้องกล้ารายงานเร็ว
สมมติพนักงานเผลอ Upload ข้อมูลผิด และรู้ตัวหลังจากนั้นห้านาที ถ้า Culture ของบริษัทคือ “ใครทำข้อมูลรั่วโดนหนักแน่นอน” สิ่งที่อาจเกิดขึ้นคือเขาเลือกเงียบ ลบ Chat แล้วหวังว่าจะไม่มีใครรู้ จาก Incident ที่อาจควบคุมได้เร็ว กลายเป็น Incident ที่องค์กรรู้ตัวช้า Security Culture ที่ดีจึงควรแยก Honest Mistake ออกจากความประมาทร้ายแรงหรือพฤติกรรมที่มีเจตนาไม่ดีให้ชัด คนต้องรู้ว่าถ้าเกิดความผิดพลาด สิ่งแรกที่ควรทำคือแจ้งทันที ไม่ใช่ปิดบัง เพราะเวลาคือหนึ่งในตัวแปรสำคัญที่สุดในการจำกัดผลกระทบของข้อมูลรั่ว การป้องกัน Data Leakage จึงไม่ได้มีแค่การสร้างความกลัว แต่ต้องมี Psychological Safety ในการ Report Incident ด้วย
Offboarding ในยุค AI ต้องมากกว่าปิด Email และรับ Laptop คืน
เมื่อพนักงานลาออก หลายองค์กรยังใช้ Checklist แบบเดิม คือคืน Laptop คืนบัตร ปิด Email และปิด Account หลัก แต่การทำงานวันนี้มี AI Account ส่วนตัว Personal Cloud Browser Extension Automation ที่ผูกกับ Personal Token Prompt Library Chat History Knowledge Base Shared Folder และไฟล์ที่ Download ไปทำงานนอกบริษัทอีกจำนวนมาก ดังนั้น Offboarding ต้องเริ่มถามเพิ่มว่า ตลอดช่วงที่พนักงานทำงาน ข้อมูลของบริษัทถูกใช้ผ่าน Tool อะไรบ้าง มี Workflow หรือ Prompt สำคัญอยู่ใน Account ส่วนตัวหรือไม่ มี Automation ไหนผูกกับ Token ของเขาไหม และมีข้อมูลอะไรที่ควรถูก Transfer หรือลบก่อนออก ยิ่งบริษัทใช้แนวทาง Bring Your Own AI มากเท่าไร ปัญหานี้ยิ่งต้องถูกคิดให้จริงจังมากขึ้น
ลดจำนวน Copy อาจเป็นมาตรการ Security ที่ง่ายกว่าที่คิด
องค์กรอาจมี Customer Master ตัวจริงอยู่ในระบบเพียงชุดเดียว แต่เมื่อเวลาผ่านไปกลับมีข้อมูลชุดเดียวกันแตกออกเป็น Excel หลายไฟล์ อยู่ใน Email อยู่ใน Drive อยู่บน Desktop อยู่ใน Presentation และอยู่ใน Chat อีกหลายแห่ง ทุก Copy คือ Attack Surface เพิ่มขึ้น ถ้าดูข้อมูลจาก Source เดียวได้ ก็ไม่ควร Download มาเก็บเองโดยไม่จำเป็น ถ้า Share Link ได้ ก็ไม่จำเป็นต้อง Attach File ซ้ำทุกครั้ง และถ้าระบบสามารถจัดการ Permission ได้ ก็ควรลดการ Export ข้อมูลออกไปเดินทางนอกระบบ บางครั้ง Data Governance ที่ดีไม่ได้เริ่มจากเทคโนโลยีซับซ้อน แต่เริ่มจากนิสัยง่าย ๆ ว่า อย่าสร้าง Copy ถ้าไม่จำเป็น
ผู้บริหารไม่ต้องดู Security Log ทุกวัน แต่ต้องมองเห็น Risk
Board และผู้บริหารไม่จำเป็นต้องรู้ว่า Firewall วันนี้ Block Packet ไปกี่ครั้ง แต่ควรเห็นภาพว่าข้อมูลสำคัญของบริษัทอยู่ที่ไหน AI Tool ใดได้รับอนุมัติ Shadow AI มีมากน้อยแค่ไหน Incident เกิดขึ้นกี่ครั้ง เกิดกับข้อมูลประเภทใด หน่วยงานใดมี Risk สูง และหลังเกิดเหตุมีการแก้ไขจริงหรือไม่ อย่าให้ Data Security เป็นเรื่องที่ Board ได้ยินเฉพาะวันที่เกิดเหตุ เพราะวันที่เรื่องขึ้นไปถึง Board ในฐานะเหตุการณ์แล้ว สิ่งนั้นไม่ใช่ Risk อีกต่อไป แต่มันกลายเป็น Incident ไปเรียบร้อยแล้ว
ถ้าจะเริ่มพรุ่งนี้ ไม่จำเป็นต้องเริ่มจากระบบใหญ่
ผมคิดว่าองค์กรจำนวนมากติดกับดักว่าถ้าจะทำ Data Governance ต้องเริ่มด้วย Project ใหญ่ ต้องซื้อ Platform ต้องตั้ง Committee ต้องใช้เวลาหลายเดือน จริง ๆ แล้วเริ่มจากเรื่องพื้นฐานให้ชัดก่อนก็ได้ รู้ว่าข้อมูลสำคัญคืออะไร จัด Classification ให้เข้าใจตรงกัน กำหนด Approved AI Tools บอกข้อมูลประเภทที่ห้ามส่ง กำหนด Owner ทบทวน Access สร้างช่องทางแจ้ง Incident และฝึกคนผ่านสถานการณ์จริง จากนั้นค่อยเพิ่ม Technology ตาม Risk ที่พบ เพราะซื้อ Security Tool ราคาแพงมาก แต่พนักงานยังไม่รู้ว่า Customer List ถือเป็นข้อมูลระดับไหน ก็อาจไม่ได้ช่วยมากเท่าที่เราคิด สุดท้าย การป้องกันข้อมูลรั่วไม่ใช่การ “ล็อกทุกอย่าง” จนคนทำงานไม่ได้ แต่คือการออกแบบสภาพแวดล้อมที่ คนยังทำงานได้ ข้อมูลยังเคลื่อนที่ได้ AI ยังถูกใช้ได้ แต่ทั้งหมดอยู่ในขอบเขตที่องค์กรรู้และควบคุมได้ องค์กรที่ปิดทุกอย่างอาจดูปลอดภัยในเชิงทฤษฎี แต่ถ้าพนักงานทำงานไม่ได้ เขาก็จะหาทางเลี่ยงระบบ ส่วนองค์กรที่เปิดทุกอย่างก็อาจทำงานเร็วมาก แต่กำลังสะสม Risk เงียบ ๆ โดยไม่รู้ตัว โจทย์ที่แท้จริงจึงอยู่ตรงกลาง คือการสร้าง Trusted Environment ที่พนักงานรู้ว่า Tool ไหนใช้ได้ ข้อมูลประเภทใดใช้ได้ ต้องระวังอะไร และถ้าไม่แน่ใจควรถามใคร เพราะข้อมูลรั่วในยุค AI หลายครั้งไม่ได้เริ่มจากคนที่ตั้งใจจะขโมยข้อมูล แต่มักเริ่มจากประโยคธรรมดามากว่า “เดี๋ยวผมเอาไฟล์นี้ไปให้ AI ช่วยดูให้ จะได้เร็วขึ้น” ถ้าองค์กรทำให้คนหยุดคิดเพิ่มอีกไม่กี่วินาทีก่อนกด Upload และมีระบบที่ช่วยให้เขาตัดสินใจได้ถูก นั่นอาจมีคุณค่ามากกว่าการเพิ่มคำเตือนอีกสิบหน้าจอ เพราะในท้ายที่สุด Security ที่ดีไม่ใช่ Security ที่คนต้องต่อสู้กับมันทุกวัน แต่คือ Security ที่ถูกออกแบบให้กลายเป็นส่วนหนึ่งของวิธีทำงานตามปกติขององค์กร
Tags: DataLeakagePrevention, ControlledDataMovement, DataInventory, DataClassification, DataMinimization, ApprovedAITools, ShadowAI, LeastPrivilege, DataFlowMapping, PrivacyByDesign, AuditTrail, DefenseInDepth, SecurityCulture, PsychologicalSafety, ExeRoot, SpaceRoot